不少工厂攒了三五年的生产数据,存在服务器里落灰,一说挖掘就喊着要上大模型,最后钱花了,结果用不起来。我在主机厂冲压车间摸了快十年,前年牵头做了第一条线的生产数据挖掘项目,踩了不下十个坑,最后把A面缺陷率降了32%,单线年降本超百万。今天把实打实的经验说给你听。
别上来就挖:先理清楚生产数据的“脏”在哪里
很多人拿到导出的CSV就往模型里塞,跑出来的结论能把人看笑。我刚接项目那会也犯过这个错。
冲压车间每台压机装了12个传感器,每秒采一次数据,单台一天就是十几万条,什么滑块偏心量、油温、成型压力、保压时间全有,看起来数据量足够大对吧?
跑了三天特征工程,出来结论说滑块间隙越大,零件合格率越高。这不是扯么?间隙大了压出来的零件尺寸公差都超了,怎么可能合格率高。
翻了三天原始数据才找到问题。换模调试的时候,操作工为了方便进件,会把滑块间隙调到最大,试模件本来就要报废,系统没做标记,直接把试模数据算进了正式生产数据集里。
这还只是最基础的坑。还有传感器误触发出来的负压力值、停电断档补数据补成的均值、换班时操作工手工录入的合格率写错数字…
做生产数据挖掘,八成时间都得花在数据清洗上,没人能跳过这步直接出成果。
我们当时是按GB/T 40790-2021《生产过程数据质量评价 指标与计算方法》,先把完整性、一致性、准确性三个指标打了分,不合格的数据全标记出来剔除,光是清数据就花了两周,比后面挖特征的时间还长。
要落地,得挖和工艺挂钩的特征
说实话,见过太多做生产数据挖掘的,根本不下车间,坐在办公室对着全量数据跑模型,出来的结论全是正确的废话。什么“成型压力不够容易出废件”,干了三年的学徒都知道,要你挖?
生产数据挖掘的核心,是把工艺工程师脑子里说不清道不明的经验,转成可量化可执行的参数,对吧?
我们车间原来一直有个问题,换模后前10件的缺陷率是正常生产的三倍,工艺工程师一直说“就是换模应力没释放”,但说不清到底要调整什么参数,调到什么程度。
我们清完数据后,没有直接把所有参数丢进去训练,而是先找三个当班的组长聊了一天,把他们平时调整的参数、习惯都记下来,转成了17个手工特征,其中就有“换模后批次顺序”“前5件尺寸偏差波动率”这两个特征。
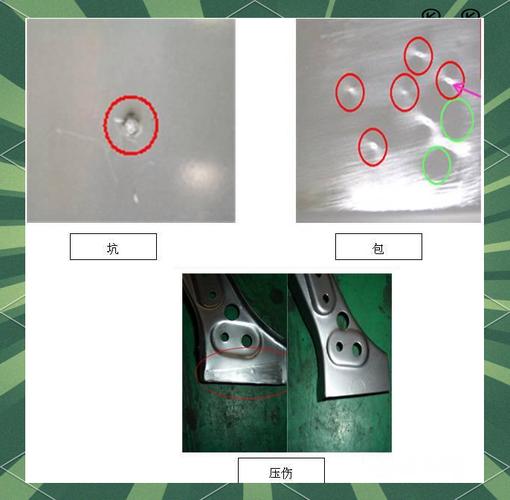
跑完相关性分析,一下子就出来了:换模后前7件的尺寸偏差波动率,和A面凹坑缺陷的相关系数达到了0.82,远高于其他任何参数。顺着往下挖就发现,只要换模后把滑块预紧间隙比标称值调小0.02mm,波动率就能降70%,缺陷率直接往下掉。
不过话说回来,这里说句掏心窝子的选型权衡,中小批量生产的工厂,你能拿到的历史数据也就两三年,撑死几十万条,瞎上什么深度学习自动提特征?纯纯浪费算力浪费时间,手工把工艺经验转成特征,效果比黑箱模型好十倍,还能给现场说清楚为什么要调,人家才愿意用。
别挖完就扔:要留好迭代的口子
我见过太多项目,交完报告就走人,过了半年工艺换了、原材料供应商换了,原来的模型准确率掉得一塌糊涂,最后工厂说数据挖掘都是骗人的。
其实生产本身就是动态的,哪来一劳永逸的模型?我们那次项目上线前,专门加了一个轻量的周更模块,不需要全量重训,每天把新的合格废件数据自动标记,每周自动跑一次特征权重更新,偏差超过5%才会报警给工艺员,平时根本不用人管。
还有,千万不要追求百分之百的准确率。我们当时做缺陷预警,做到91%的时候,再往上提,每涨一个点就要多加三个传感器,成本涨了十几万,我们直接停了。现场只要能把九成的缺陷提前拦下来,就已经赚回几倍的成本了,剩下那点小概率的特殊情况,让质检拦一下就行,没必要追求完美。
哦对,还有个很容易忽略的点,你挖出来的结论,得转换成一线能看懂的话,别给人甩个ROC曲线就完事。我们当时给车间的结论就是“换模后前7件,滑块间隙调小0.02mm,每台每月少出120件废件”,算完账一年省一百多万,车间主任当场就拍板全line推,根本没有落地阻力。
生产数据挖来挖去,核心还是解决生产的真问题。别玩花活,别炫算法,多下车间转,多跟操作工工艺员聊天,把脏数据理清楚,把经验转成参数,就能掏出真金白银的成果。
