摘要:本文从国内中小离散制造企业的实际产线数字化需求出发,分享了产线运行多维度统计数据分析平台从需求梳理到落地运行过程中的选型经验、踩坑记录和实际收益,所有内容都来自真实项目,可供负责产线数字化改造的中级工程师参考。
为什么我们要推翻原有方案,重做产线统计平台?
去年中秋前赶大订单,出了一起批量不良,品控部追了三天根因,最后卡在数据上。三个工位的节拍统计对不上,出问题那台机的温度记录存在本地工控机,早就被新的运行数据覆盖了。最终只能全批次返工,损失小二十万。
之前我们产线用的是什么统计方式?每个工位自己填手工报表,每周导一次OA数据,月底运营部凑起来做全月统计。数据分散,口径不统一,出了问题查不到,就连最基础的OEE计算,误差都能到18%。
那时候我们就拍板,必须搞一个真能用的产线运行多维度统计数据分析平台,不是贴在车间门口给客户看的网红看板,是能帮一线找问题、降损失的工具。
核心维度设计:三个踩过的选型坑,个个戳痛点
一开始做需求,我们团队差点走极端:有人说要把所有能采集的数据都存进来,什么电网电压、车间湿度、员工离岗时间,全都算进统计维度。结果原型跑了半个月,数据冗余度超过62%,查询一次年度平均节拍数据要等17秒,车间调度打开一次直接关掉,说不如用原来的Excel。
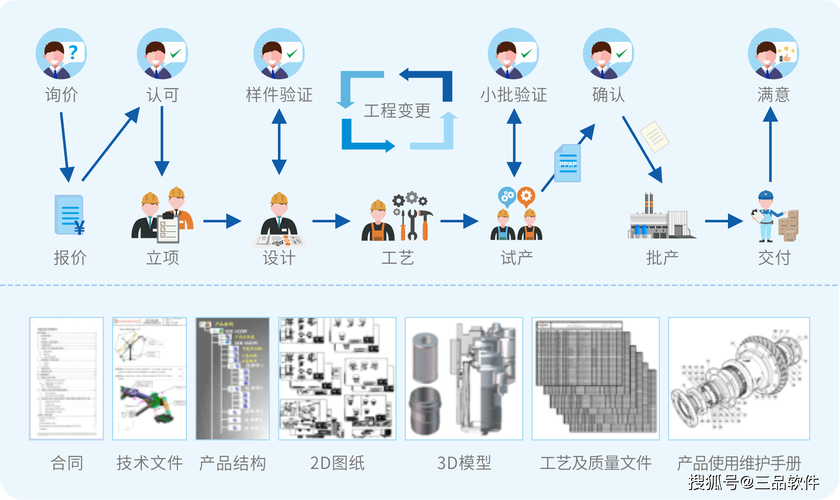
后来翻了GB/T 41261-2022《智能制造 生产过程数据采集交互导则》,里面明确给了统计维度的分层原则,一下子点醒我们。最终我们把所有维度分成三层:核心运行维度、辅助环境维度、管理辅助维度。核心维度只保留和OEE直接相关的五项:节拍、良品率、换型时间、故障停机时长、设备负荷,这部分存在高速时序库,保证查询速度。剩下的辅助维度按需挂载,需要做关联分析的时候再调用,不用占主库的资源。这下查询速度直接提到1.2秒以内,没人说慢了。
第二个坑,时序库选型。一开始为了省钱,选了热门开源方案,结果三个月数据量破500G之后,连续写入丢包率跑到0.3%。别小看这0.3%,统计年度平均故障间隔的时候,误差直接差了12分钟,给生产部做汇报的时候,被骂到狗血淋头。后来换了TimescaleDB,基于PostgreSQL优化的时序库,对多维度聚合查询的适配做得非常好,现在丢包率稳定在0.001%以下,虽然多花了两台服务器的成本,但换来了稳定,太值了。对吧?
第三个坑,维度交互设计。一开始做的是固定看板,想看节拍切一页,想看不良率又切一页,车间班长泡在现场,哪有空来回切页面找数据?我们改了三次,最后改成自定义维度拖拽,常用的维度组合可以存个人模板,一线自己就能改,不用每次都找信息部调整,省了不知道多少对接时间。
说实话,做工业级平台最容易犯的错,就是工程师躲在办公室拍脑袋,觉得逻辑通顺就完事,完全不考虑用的人是什么使用场景。
上线半年,超出预期的额外收益
我们做这个平台的初始目标,只是把OEE统计准确率从原来的82%提到95%,完成集团给的数字化KPI。没想到上线跑了半年,帮设备部解决了一个好几年没搞定的老问题。
年初设备部做年度预防性维护计划,把平台里近一年的故障停机数据拉出来,做多维度关联分析,把故障和环境温湿度、毛坯批次、连续开机时长做交叉,发现车间那台进口冲压机的滑块故障,80%都出现在连续开机超过12小时、车间湿度大于60%的时候。原来我们都是按固定三个月做一次保养,不管实际运行情况,改完动态保养方案之后,这台机的故障停机率直接降了27%,光是年度维护成本就省了十几万。
哦对了,还有个细节很多人都会忘,我提一句。做统计分析的时候,一定要按JB/T 13718-2019《机械工业生产过程统计分析方法》的要求,用三倍标准差法剔除调试、换型阶段的异常值,不然个别异常数据会把整个统计结果拉偏,你得到的结论就是错的。我见过不少新项目栽在这一步,别踩坑。
不过话说回来,我们这个平台也不是十全十美。现在还有三台九十年代的老机台,没有标准数据接口,数据还是靠人工录入,偶尔会出录入错误,今年下半年排了改造计划,慢慢改。
很多工厂做数字化,总想着一口吃成胖子,一步到位搞全自动化无人工厂,钱花了一大堆,最后用不起来。其实产线数字化改造,先把核心的统计分析做扎实,能用,好用,能解决实际问题,比什么花里胡哨的概念都强。
产线运行多维度统计数据分析,本质就是给产线做定期全身体检,维度选对了,数据准了,才能提前查出毛病,真真切切降本增效,不是做给领导看的样板工程。
