上周有个做注塑机的老哥来找我,说他们的设备数据回传方案上线三个月,云端存了四十多个T,结果客户真正打开看过的曲线不到三条。我笑了。这事儿太典型了——大家把「回传」当成一个通信问题,其实它从头到尾都是一个信息取舍问题。
先把话说在前头:设备数据回传,不是把现场所有字节原封不动搬到服务器上就叫完事了。那是搬运工,不是工程师。
先算账,再谈协议
我见过太多项目,方案评审会开了三轮,MQTT和OPC UA吵了两周,从头到尾没人算过一句带宽。真的。你想想,一个齿轮箱状态监测系统,12个加速度通道,采样率25.6 kHz,24位量化——这已经是很常规的配置了,按ISO 13374-1那套状态监测架构,这就是最底层的原始数据层。
算一下:12 × 25600 × 3 字节 = 921,600 B/s,也就是约0.92 MB/s。如果每十分钟采10秒,那就是9.2 MB一次,一天144次——单台设备一天就是1.3 GB。而一个风场有50台机组呢?65 GB/天。一年下来,光存储成本就能把整个项目的预算吃掉一小半。
所以第一件事,不是选协议,是决定回传什么粒度的数据。我一般分三档:原始波形只在触发事件时回传(比如振动烈度越过ISO 20816-3的报警线);中间层回传时域特征值,RMS、峭度、峰值因子、包络谱前若干阶;最上面那层只回传状态码和健康指标。三层各司其职,带宽立马降两个数量级。

协议选型:别被PPT忽悠了

Modbus RTU?便宜、皮实、几乎每台PLC都支持。但它有个隐藏成本,很多人不算:轮询延迟。9600 bps下,读一个保持寄存器的往返大概10到15毫秒,你一条RS-485总线上挂50个从站,一轮扫下来就是0.5到0.75秒。你想做毫秒级的故障捕捉?做梦。
OPC UA(IEC 62541)好得多,订阅模型、信息建模、内置安全。但它的二进制编码在嵌入式端实现起来,内存占用不是闹着玩的。我在一颗Cortex-M7上试过开源栈,开完session和subscription,堆已经吃掉一大半。剩下的留给谁?
MQTT呢,OASIS标准,报文头最小只有2字节,天生适合弱网。但这里有个经典坑——QoS等级选错。QoS 0是「发了就不管」,网络抖一下就丢;QoS 2是「恰好一次」,但握手四次往返,现场4G信号一差,延迟能堆到秒级。多数场景QoS 1其实是最优解,配合上行消息里带一个单调递增的序列号,接收侧做去重,比指望协议层靠谱。
还有Sparkplug B这套规范,定义了主题命名和状态机,做设备在线/离线管理确实省事。不过它对Payload的编码有强约束,你的老设备要是拿不到那些字段,就得在边缘网关上做映射——这份映射表维护起来,说多了都是泪。
时间戳,才是数据能不能用的命门
这点最容易被忽略。数据回传到云端了,看起来漂亮,但你要做阶次分析、做多通道相干、做跨设备因果推断,时间不同步,一切都白搭。
NTP在工业现场的实际抖动,±10毫秒是常态,遇上交换机拥塞能到几十毫秒。这么点偏差,对温度趋势无所谓,对25.6 kHz的振动信号就是灾难——两个通道的相位关系直接崩了。
所以只要涉及多通道同步采集,我会坚决要求上IEEE 1588 PTP,边界时钟加透明时钟,亚微秒级对齐。贵吗?贵。但比返工便宜。
另外,时间戳要在采集那一刻打,不是网关转发的时候打。我踩过这个坑:网关自己的时钟没同步,转发时统一盖了个章,结果所有数据的时标都偏移了同一段,事后查了一周才发现问题出在那台设备的RTC电池上……
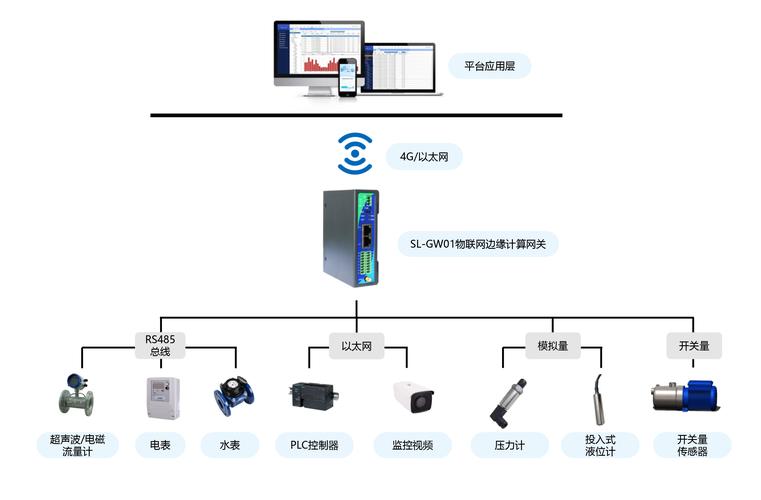
断网了怎么办?这是必答题
现场网络不会一直好。你要做的是让数据在断网期间不丢、不乱序、不重复。
边缘侧得有本地环形缓冲。文件系统别图省事直接用SQLite高频写,闪存的写放大能把SD卡三个月写废。我一般用预分配的定长环形文件,配合同步刷盘策略,攒够了批量落盘。
恢复连接后,先补传历史,再切实时流。这两条通道最好分离,否则补传会把实时数据堵在队列里,监控画面直接卡死。真实场景里,客户可不会理解「正在补传」这种理由。
还有一点,回传要有优先级。报警事件、状态变化,插队走;常规趋势数据,慢慢排队。一套不做优先级的队列,在弱网下就是一团乱麻。
说点掏心窝的

做设备数据回传,技术本身不难,难的是知道**什么该传、什么不该传**。我见过把每一帧CAN报文都往云上灌的方案,也见过只传一个健康度百分比的方案,前者烧钱,后者没用。中间那条线,得靠你对设备本身的理解去划。
传感器不懂你的业务,网关也不懂。只有你知道,哪一段数据里藏着真正的故障征兆。回传策略,本质上是你对这台设备的理解,用工程语言写了一遍而已。
别急着选协议。先坐下来,把你要回答的问题列出来,再倒推需要什么数据、什么精度、什么时延。顺序反了,后面全是补丁。
