2026-10-01 00:37:03 分类:机械设计
上个月带毕设。一个做减速机剩余寿命预测的小孩,卡了三周。
拿到的传感器数据攒了快十个G,开口就问我:老师,说好的工业多源异构数据融合,我怎么连第一步都跑不起来?
一开始我也踩了坑
备这部分内容的时候,我翻了不下二十篇核心期刊论文,也看了好几门慕课的内容。几乎所有内容都在讲融合算法的精度,讲不同融合架构的创新点,连数据示例都是整理到不能再整理的标准公开数据集。我想当然觉得,不就是把不同来源的数据拼一块喂模型嘛,学生肯定能搞定。
直到这个小孩把他的数据打包发我,我解压开一看也懵了。
振动传感器的数据是二进制存的原始采集包,温度数据是PLC导出来的带逗号分隔的TXT,电机电流数据是MES系统导出的Excel,还有几个停产排班的标注数据,存的是JSON格式。采样率差了一万倍,时间戳不对齐,零飘的脏数据混在里面,连坐标系统一都没做——三个传感器装在不同位置,测得的振动数据坐标都是偏的。
说实话,那时候我才反应过来,我们教了太多“结果”,没教“开头”。
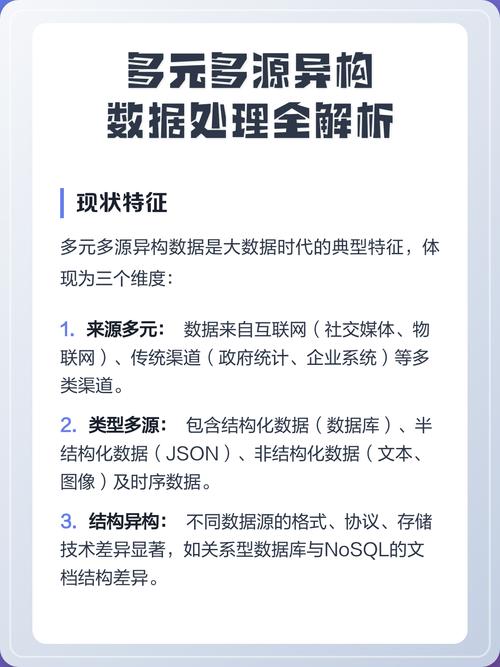 机械故障监测多源异构数据格式对比表
把抽象概念拆成摸得着的三步
我拉着他在实验室坐了一下午,没讲算法,先理清楚到底要做什么。
第一步,先做时间空间对齐,别上来就想着融。不同传感器采样率不一样,先把时间戳拉齐,高采样率的做合理重采样,低采样率的做插值补全,把所有数据统一到同一时间轴上。空间上更不用说,传感器安装有偏差,先把坐标转成同一个坐标系的,别把不同位置的特征混为一谈。更重要的是,把工业场景信息加上——哪天停产,哪天满负载,哪天半负载,这些工艺数据也要对齐标进去。
第二步,格式归一+清脏数据。工业现场哪来那么多标准格式?你拿到什么就是什么,先统一转成带标注的数组格式,把空值、零飘、跳变的异常数据清出去。这小孩一开始舍不得清,觉得丢了可惜,结果清掉三分之一的停产零飘数据之后,模型准确率直接涨了二十多个点。
第三步,才轮到选融合的方式。别上来就堆最复杂的算法,要看你的落地场景。你要跑在工厂的边缘盒子里,就别用数据级融合堆原始数据,算力根本扛不住。提完特征再融,不好吗?
他最后选了特征级融合:振动数据提频谱和熵特征,温度电流提统计特征,工艺特征做独热编码,拼起来之后接一个简单的分类器,笔记本就能跑,结果还挺干净。
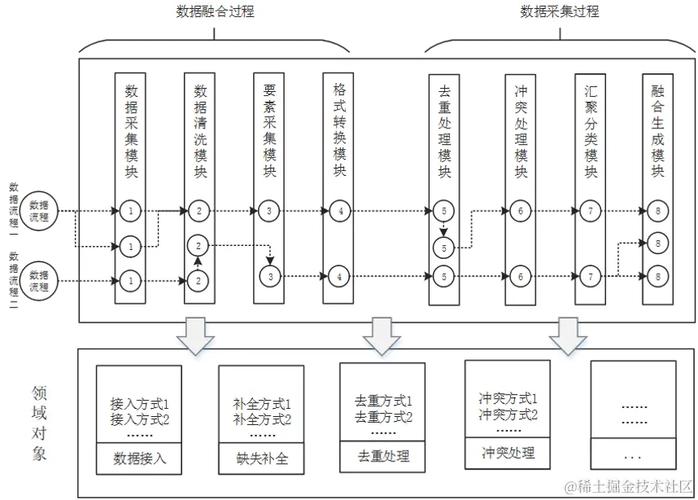 工业减速机状态监测数据融合处理流程图
教学要留的混沌空间
 教学要留的混沌空间
原来我备课,总喜欢把概念分类分的清清楚楚:数据级、特征级、决策级,一条一条列在PPT上,让学生背。
现在我不这么干了。
工业现场本身就是混沌的。哪有人提前给你分好类,告诉你“这个用特征级融合,那个用决策级”?你拿到的就是一堆来源不同、格式不同、质量不同的数据,你要做的是取舍,不是背定义。
不过话说回来,我们机械设计方向教数据智能,本来就不是培养算法专家,是培养能解决工业实际问题的设计师。你不需要发明新的融合算法,你只要知道什么时候用什么方法,能把手里乱七八糟的数据变成能用的结果,就够了。
这次之后我改了课程大纲,把原来用来讲算法分类的两个课时,拿出来一个半给学生练“处理脏数据”。找工厂要了一份真实的未处理的减速机监测数据,让学生自己踩坑,自己调,自己做对齐清数据。
有不少学生做完之后说,原来以为融合是多么高大上的东西,原来一大半功夫都花在处理乱七八糟的数据上。对啊,这才是真实的工业场景啊。
之前总有人说,机械设计要跟上数字化转型,要教新东西。可新东西不是堆新概念,不是把AI的名词全搬上PPT就叫转型了。要把概念拆成学生能踩的坑,能摸得着的步骤,能自己做完的项目,才叫真的教会了。
那个小孩预答辩的时候,评委问他,你为什么选特征级融合不选数据级?他说,我要做的就是车间边缘端的监测,数据级融合算力不够,我这个够用,精度也满足要求。评委听完都点头。
我坐在下面听,挺感慨的。我们教了这么多年书,其实就是帮学生把那些高大上的名词,拆成脚下一步一步的路而已。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:学生卡了三周的坎:工业多源异构数据融合到底教点啥
文章链接:https://www.yqhljx.com/list_9/3620.html
