这是给一线中级工程师的落地分享,不讲虚头巴脑的概念,只说我这几年做项目踩过的坑、摸出来的实诚经验,看完就能避开绝大多数平台搭建的陷阱。
别拿存量数据仓库改改就叫深度治理挖掘平台
很多工厂现在上平台,图省事,就是把原来MES、ERP、设备PLC里攒的旧数据导去新仓库,挂个BI看板就敢对外叫工业数据深度治理挖掘分析平台。骗得了领导,骗不了干活的。
我前两年接的汽车零部件冲压车间的项目,甲方就是这么干的,攒了三年的冲压机振动、模具温度数据,号称「百万级样本」,要做模具寿命预测,结果跑出来的模型准确率不到38%。谁都搞不清问题出在哪。拉了原始数据一看,嚯。82%的采集数据是设备停机待机时候的空记录,模具型号换了没改标签,不同车间的同型号设备,参数单位一个用公制一个用英制,混在一起根本没法用。
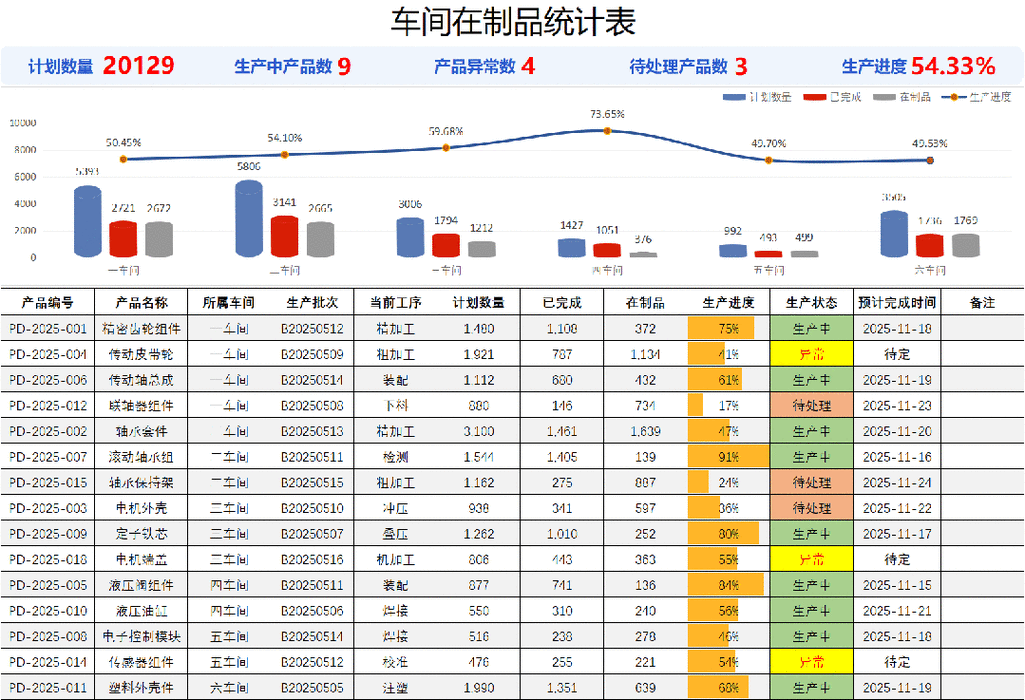
说实话,我见过八成以上工业数据项目,死的不是算法不好,是数据根本没治干净。深度治理的第一步,永远不是搭模型,是做数据血缘梳理,按照GB/T 41479-2022《数据治理 工业数据分类分级要求》,把每个数据从采集、传输、存储到出报表的全链路理清楚,哪些是核心生产数据,哪些是辅助日志,哪些是无效空采,全部分类打标。
这步脏活累活,没人愿意干,很多项目直接跳过,上来就挖。相当于拿泔水熬佛跳墙,能好吃吗?
核心模块的选型权衡:别堆开源工具凑数
平台搭起来,核心就是两层:治理层、挖掘层。很多团队为了省成本,全堆开源工具,Pandas做清洗,Scikit-learn做挖掘,攒个Web壳就上线了。能用吗?小项目玩玩还行,上了规模直接崩。
去年我帮一个热电厂收拾烂摊子,他们自己攒的平台就是这么干的,碰到10万点/秒的实时机组数据采集,并发三个用户访问挖掘任务,直接卡成静态网页。更坑的是数据处理逻辑,他们缺失值直接用全样本均值填充,汽轮机转子启停阶段的温度缺失值,填了额定工况的温度,最后算出来的蠕变寿命比实际值偏了15年,差点把还能安全用5年的转子换了,小一千万就没了,你说吓人不吓人。
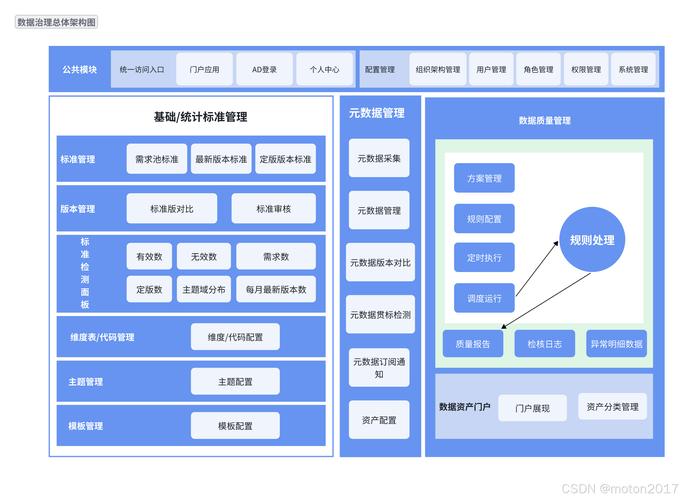
那选型到底怎么选?我说句实在话,看你的场景。要是你是小批量离散制造,年数据量不到1TB,那用开源工具凑活没问题,能省则省。要是你是流程工业,或者大规模离散制造,年数据量十几TB甚至几十TB,治理层一定要基于成熟的工业实时数据库做扩展,别自己从头写存储。挖掘层别用单节点的开源库,一定要上分布式的特征工程框架,不然跑一次关联规则要十几个小时,没人耗得起。
不过话说回来,也不是越贵越好,我见过有人上来就买几百万的全模块平台,结果只用了10%的功能,纯纯浪费钱。选型就是权衡,适合自己的生产场景才对。
落地才是硬道理:我们真挖到了什么有用的
说回最开始那个冲压车间的项目,我们花了一个半月理数据、清脏、打标,把原来分属采购、设备、生产三个系统的数据全部打通,原来采购的材料硬度数据一直在ERP里躺着,从来没和模具磨损数据关联过,治理完之后我们做特征交叉挖掘,挖出来一个非常实用的规律:当冲压用板材的硬度波动超过HRC 1.5的时候,哪怕总硬度在来料合格范围内,模具的磨损速度也是正常波动下的2.7倍。
这个规律,车间干了22年的老主任都没总结出来,因为之前没人能把每一批板材的硬度对应到每一套模具的磨损量上,数据散在三个部门,从来没凑齐过。信息壁垒就在那,你不打破,永远挖不出东西。
后来甲方按照这个规律,提前对高硬度波动批次的板材调整冲压次数,适当提早换模,模具废品率直接降了12个百分点,一年下来省了超过230万的原材料和模具成本。这才叫平台的价值对吧?
很多平台做出来,就是展厅里放着,给参观的领导演示两下,实际生产根本用不起来,挖出来的规律全是正确的废话,比如「设备温度高了容易坏」,谁不知道呢?白瞎了几百万的投入。
做了快五年工业数据相关的项目,最大的感受就是,工业数据深度治理挖掘分析平台,拼的不是算法参数有多顶尖,是你愿意不愿意沉下去做没人愿意做的脏活累活。把数据理清楚,对准现场的实际问题,自然能挖出来真金白银的价值。花架子搭得再好看,没用。
