2026-10-19 16:44:57 分类:机械设计
不少做设备数据分析的工程师都有过这种经历:熬了半个月调出来的预测模型,上线就拉胯,查来查去最后发现是输入的采集数据根本没做针对性清洗。这内容全是在机械加工现场跑了快十年攒的经验,没有虚头巴脑的高大上理论,全是能直接落地的实操逻辑和实打实踩过的坑。
上周帮苏州一家汽车零部件厂排查伺服电机的振动预测模型,跑出来的结果离谱到什么程度?模型说精加工工位的正常切削振动比冲床的还高3倍。查了整整三天,根因根本不是模型参数调优的问题——是采集的振动数据里混了大量人工点检时碰传感器的尖峰噪声,还有PLC传输时丢包系统自动补的默认0值,从源头就没做过针对性的清洗。
先搞懂:工业脏数据根本不是互联网那套脏数据
很多人对脏数据的认知还停留在互联网场景——用户填的空手机号、重复提交的评论、乱码的留言。放到工业场景里,这套认知半毛钱用都没有。工业现场的脏数据,是带着明确物理特征的:比如机床的切削温度数据,突然跳个1200℃,可能是热电偶接线松了的瞬时跳变,可能是换刀时空采的环境温度,甚至是车间大功率设备启停时EMC干扰打出来的假值。
很多刚从互联网赛道转过来的工程师,最容易犯的错就是直接把通用的异常值筛选逻辑套在工业数据上,完全不管信号本身的物理意义。
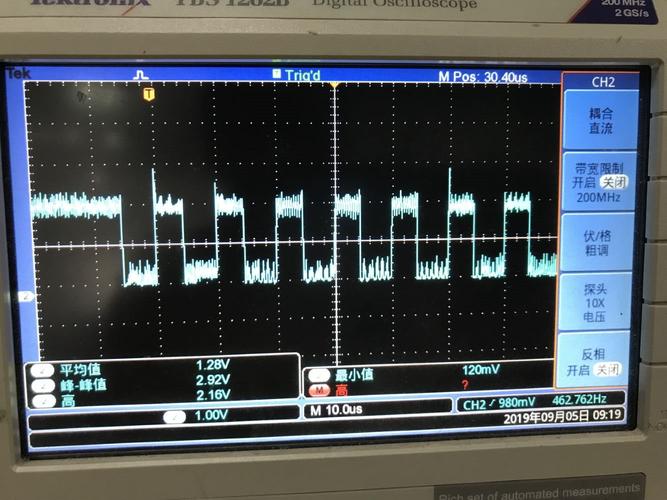 车间热电偶传感器信号采集异常波形图
这种照搬过来的规则,往往会把正常工况下的工艺波动当成异常值删掉,最后整个数据集看起来完美光滑,实际上没有任何分析价值。真的,我到现在都记得去年碰到的一个刚毕业的小年轻,做刀具寿命预测的时候,直接拿3σ原则筛温度异常值,把磨床正常砂轮钝化阶段的温度上升全给当异常删了,最后模型跑出来的准确率连40%都不到,急得满头汗的时候我给他指出来,他才反应过来自己连砂轮钝化的基本工艺都没搞懂。
最容易踩的三个清洗误区,全是现场真金白银砸出来的教训
第一个坑是盲目追求“零异常”。很多人做清洗,恨不得把所有偏离均值的点全删掉,最后数据集看着整整齐齐,实际上根本没法人用。2022年给某风电齿轮厂做传动链故障预警,一开始的清洗团队把所有超过2倍标准差的振动幅值全删了,结果模型上线后连轴承内圈剥落的早期故障信号都识别不出来——因为早期故障的信号本来就是偏离正常均值的小幅尖峰啊!你全删了,还预警个啥?
工业数据清洗的核心目标不是得到“完美的正态分布数据集”,而是保留所有具有物理意义的有效信号,把真正的无意义噪声剔出去。
第二个坑是不分数据源优先级混着洗。同一个工位的压力数据,可能有三个采集来源:机床内置IO模块测的、外接的高精度压力传感器测的、MES系统人工录入的点检值。这三个的精度根本不在一个量级——内置IO的采样精度是1%FS,外接传感器是0.1%FS,人工录入的误差可能有5%。你要是把这三个源的数据放一块算均值、去重,那最后出来的结果偏差能大到让你怀疑设备是不是装反了。
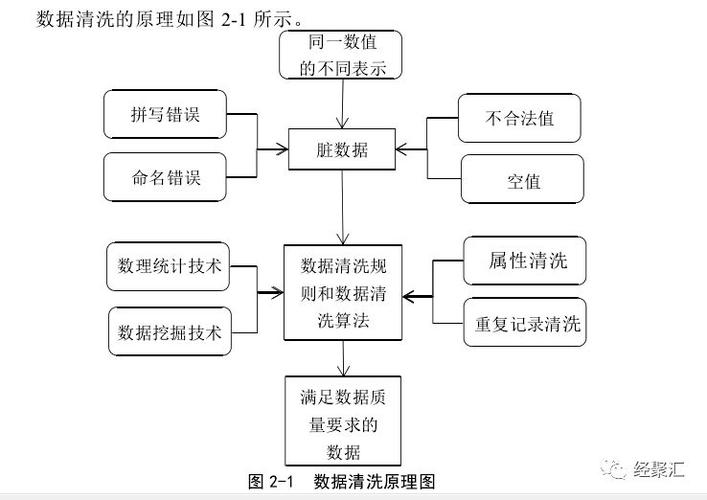 工业多源传感器数据清洗流程架构图
第三个坑是洗完不做回溯校验。很多人清洗完数据,存到数仓里就不管了,过了三个月要做工艺优化分析,才发现之前把某个班次的主轴转速数据全给滤没了——那个班次刚好是新切削参数的验证期,丢了这部分数据,之前半年的工艺试验全白搭。我之前碰到过一次,团队为了赶项目上线,清洗的时候没留原始数据快照,最后工艺追溯的时候找不回来原始值,被生产部追着追责的那俩月,我连去食堂吃饭都得绕着生产部的同事走。
真正落地能用的清洗逻辑,根本不需要复杂的大模型
现在市面上吹工业大模型做数据清洗的人不少,实际上在绝大多数离散制造的车间里,根本没有那么多标注好的故障数据喂给大模型。真正靠谱的清洗逻辑,其实是三层递进的校验,简单好落地,准确率还高。
第一层是刚性的物理边界校验。这是最没有商量余地的规则:比如普通立式加工中心的主轴最高转速是12000rpm,那超过这个值的点,不管什么情况,全是异常——除非你机床改装过高速电主轴,那再单独改阈值。还有比如切削液的正常工作温度范围是15℃到45℃,那突然出来个80℃的值,要么是传感器坏了,要么是采集线串到加热回路了,直接标记成异常就行。参照GB/T 33905.3-2017《智能制造 工业数据 第3部分:数据质量评价规范》里的要求,时序数据的孤立跳变点占比超过0.1%就需要立刻触发数据源排查,这个阈值很多人用了都说靠谱。
第二层是时序连续性校验。工业数据是按固定采样频率连续采集的,相邻两个采样点的变化率是有物理上限的。比如振动信号采样频率是10kHz,那相邻两个点的幅值差不可能从0.1g直接跳到10g——除非是真的发生了刀具碰撞,但碰撞的信号是连续的几个尖峰,不是单个点的孤立跳变,碰到这种孤立跳变直接标记成采集异常就行。
第三层是业务规则校验。比如换刀的时候,主轴转速会降到0,切削力会降到0,这时候如果采集到的切削力是额定值的80%,那肯定是数据传输丢包了,补值的时候就找前后相邻几个换刀周期同位置的数值插值就行,别用全局均值补——全局均值补出来的数,跟实际工况根本对不上。
说实话,我见过太多公司花几百万搭工业互联网平台,买了最贵的数仓,配了最厉害的算法团队,结果最后卡在数据清洗这一步。大家都觉得清洗是脏活累活,是没人愿意干的边角料,没人愿意扎到车间里去跟操作工、跟设备维护的师傅聊,不知道每个传感器装在哪,不知道每个采集通道什么时候会受干扰,不知道换刀的时候信号是什么样的,坐在办公室里拍脑袋写清洗规则,那能做好才怪。
所有清洗规则的阈值,从来不是坐在办公室里靠算均值算出来的,是蹲在车间里跟设备师傅一起,看了几百小时的正常工况波形、几十次故障波形,一点点校准出来的。
工业数据清洗从来不是什么高大上的技术活。它本质上是你对现场设备、对生产工艺足够熟了之后,自然推导出来的一套规则。你对现场的了解越深,写出来的清洗规则就越靠谱,最后出来的数据质量就越高。别总想着靠什么复杂算法、什么大模型去替代对现场的认知——那些东西在没有干净数据的时候,全是空中楼阁。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:工业数据清洗:机械产线现场踩出来的实操避坑指南
文章链接:https://www.yqhljx.com/list_9/4599.html
