摘要:本文结合长三角三家汽车零部件加工厂的算力调度落地经验,梳理了工厂场景下碎片化算力的实际损耗、统一调度的技术边界,以及跨部门协同的落地细节,没有空泛概念,全是一线踩出来的实锤。
上个月跑了三家长三角的零部件加工厂,踩完一圈算力调度的坑,回来整理了半本笔记。
最开始去第一家厂的时候,IT部的人给我看他们的算力台账:12台配RTX A6000的CAE仿真工作站,归设计科管;8套带T4算力卡的视觉检测工控机,归制造部管;6个部署在车间的数字孪生边缘节点,归运维部管。每个节点的采购价都不低,算下来三年投的硬件成本快八百万。
我盯着监控面板愣了三分钟。
设计科的工作站,除了排模、跑CAE仿真的那几个小时,GPU平均负载才12%,剩下的时间全在跑屏保。产线的视觉工控机,白天两班倒的时候负载能冲到90%,晚上换班的那四个小时,负载直接掉到15%。边缘节点更夸张,平时只跑数据采集,CPU负载常年在10%以下。
太离谱了。
合着大几百万投的算力,三分之二在睡大觉?之前大家习惯了把算力跟着设备、跟着科室配,设计科的工作站不许产线碰,产线的工控机不许装仿真软件,权限墙、网络隔离、软件授权锁,一层一层把本来连通的算力拆成了互不相通的碎块,最后算下来单块模具的仿真成本比行业平均高了40%,视觉检测的算力冗余占比超过60%。
碎算力的浪费,比你算的账还多
很多人算算力账的时候,只会算硬件采购的钱。真的落地过才知道,隐性成本比硬件钱高多了。
比如设计科跑一个1200万网格的冲压成型仿真,单台工作站要跑14个小时,为了赶模具交付的节点,工程师只能把任务拆成好几个小模型,分开算,最后拼出来的仿真结果和实际成型的误差能到18%,后续修模的成本又要多掏十几万。产线那边呢,为了应对白天的高负载,给每个视觉工位都配了最高规格的算力卡,结果晚上闲下来的时候,这些算力完全空转,连个数据清洗的任务都跑不了。
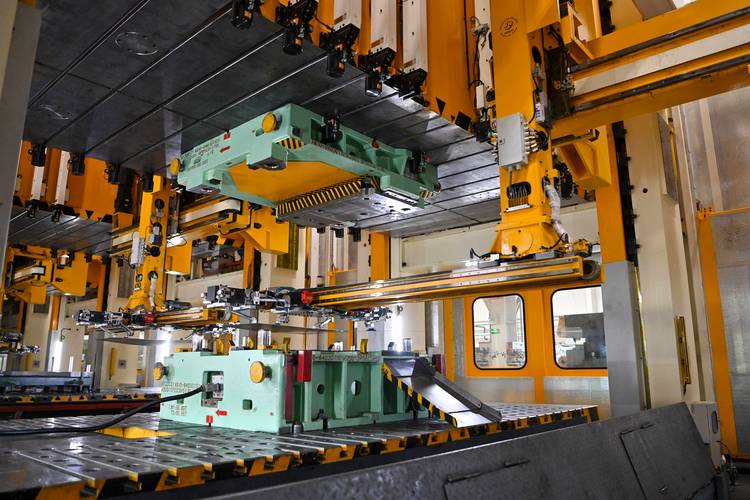
我在第二家厂算过一笔细账:他们一年因为算力碎片化导致的额外成本,包括仿真精度不够的修模费、算力冗余的硬件折旧、软件授权的重复采购,加起来快三百万。这还没算因为仿真周期太长,错过客户订单交付期的潜在损失。
统一调度的核心,从来不是把机器堆进机房
最开始接触这个项目的时候,好几个厂的IT负责人跟我说,统一调度不就是买个云管平台,把所有机器的网线连起来,做个资源池就完事了?
真的,别拿消费级云调度的思路套工业场景。
按照GB/T 41391-2022《智能制造 工业算力通用要求》的分级,工业场景下的算力任务分三类:第一类是生产控制类,比如冲压设备的实时控制、视觉检测的缺陷识别,要求端到端延迟低于10ms,绝对不能跨节点调度;第二类是数据处理类,比如产线的质量数据清洗、设备的预测性维护计算,要求延迟低于1s,可以在车间范围内调度;第三类是离线计算类,比如CAE仿真、数字孪生的大场景渲染,没有硬延迟要求,可以跨车间、跨科室调度。
损失真金白银。之前有个同行的厂,上来就照搬互联网公司的云调度方案,把所有算力节点拉到同一个大资源池,连产线上实时跑的视觉检测任务都迁到了几公里外的中心机房,结果赶上车间核心交换机动升级,三秒钟的网络断连,120个带表面微裂纹的冲压件没被识别出来,顺着产线流到了总装环节才被巡检发现,光是拆解返工、耽误总装节拍的损失就超过二十万。
真正能落地的调度系统,核心是三个模块:首先是算力感知层,要实时采集每个节点的GPU/CPU/内存负载、网络带宽、剩余软件授权数,甚至要考虑节点的车间环境温度——夏天38度的车间里,没有空调的工控机会自动降频,实际可用算力比标称值低15%左右,这些数据都要算进可用算力池里,不能拿标称值瞎算。然后是任务匹配层,给每个任务打好实时性、安全等级的标签,带10ms延迟要求的任务,永远锁在本地边缘节点,不许跨车间调度;大的仿真任务,就把闲下来的设计科工作站、晚上空转的视觉工控机的算力攒起来,我们测过,10个闲节点的分布式算力,跑同样的1200万网格仿真,3个半小时就能跑完,比单台工作站快了4倍。最后是安全隔离层,哪怕算力统一调度了,生产网和办公网的逻辑隔离不能丢,比如从视觉工控机划出来的算力,只能跑非生产类的仿真任务,不能碰实时检测的数据流,每次调度都要做权限校验,防止越权访问。
落地时最容易被忽略的软成本
讲完技术细节,说点不太好听的。很多项目最后做砸了,根本不是技术不行,是没算清楚软成本。
比如跨部门的利益墙。设计科的工作站,原来都是科室自己说了算,现在调度系统要在闲的时候把算力分给产线做数据处理,设计科的工程师第一反应就是“会不会我跑仿真的时候抢不到算力?” 对吧,谁的东西谁心疼。我们当时做的方案是,给每个科室设算力配额,哪个科室的节点贡献的闲时算力,按照70%的比例折算成该科室可以免费使用的公共算力池额度,相当于存算力换算力,大家才愿意配合。
还有软件授权的坑。很多仿真软件的授权是绑定节点MAC地址的,你把任务调度到别的节点上,授权就不认了。之前有个厂为了省授权费,硬把绑定MAC的授权拆出来用,结果跑了一半的仿真任务因为授权校验失败断了,三个小时的计算白跑。说多了都是泪。后来我们的方案是,统一部署浮动授权服务器,按照实际的算力使用时长算授权费用,不用给每个节点买永久授权,光这部分一年就能省三十多万。
我们帮第一家厂做完整套调度系统之后,连续跑了三个月的统计:整体算力利用率从原来的28%涨到了67%,单套模具的仿真周期缩短了62%,视觉检测的算力冗余从63%降到了12%,算下来一年省的算力投入、软件授权、仿真时间成本,差不多两百四十万。投入的调度系统、网络改造的钱,不到一年就收回来了。
其实工厂的算力调度,从来不是什么高大上的AI命题。说白了就是把原来散在各个角落、睡大觉的算力,按照不同的任务要求,放到合适的位置用起来。没有那么多玄乎的概念,踩过的坑、算过的细账、协调过的部门诉求,才是真正能落地的核心。
