引子:一条产线停了,问题出在螺栓上,根子却在数据链上
去年冬天,我去苏北一家做精密减速机的厂子帮忙。凌晨两点,一条磨齿机产线突然报警停机。操作工说主轴振动值跳了。实际上主轴没坏,是拧在轴承座上的那个M8螺栓松了半圈。传感器测到了异常频谱,但数据在PLC里躺了十几分钟才被SCADA轮询走。等值班工程师看到报警,砂轮已经崩了边。 你瞧,我们谈物联底座,谈的从来不是云平台有多漂亮。是振动信号从加速度计出来那一刻,到最终触发停机指令,这中间到底走了多少冤枉路。说实话,这件事让我对“底座”两个字的理解彻底翻了个个儿——它跟数据量没关系,跟数据到达的确定性有关系。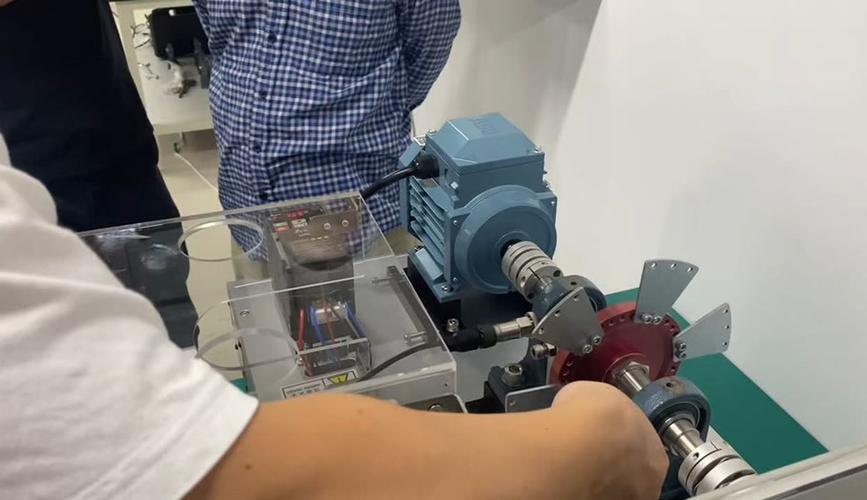
一、机械工程师容易忽略的第一层:物理量的语义化定义

二、边缘侧的时序对齐:你的Kafka消息可能全是乱的
好,假设物理量定义清楚了。第二个致命问题:时间戳。 很多工厂的传感器是通过Modbus RTU接入边缘网关的。Modbus本身没有时间戳概念。网关轮询到数据后,打上本机时间。问题是,网关的NTP同步可能偏了200毫秒。而同一台设备的振动传感器走IO-Link,IO-Link Master有自己的本地时钟,又偏了50毫秒。这两路数据到了边缘服务器上,做FFT分析的时候,相位差对不齐。 我吃过这个亏。一个风电齿轮箱测试台,齿面磨损特征频率在啮合频率附近。采集卡和PLC数据差了12毫秒,边频带整个糊掉,误判成轴承故障。后来查了三个月才发现是时间戳对齐的问题。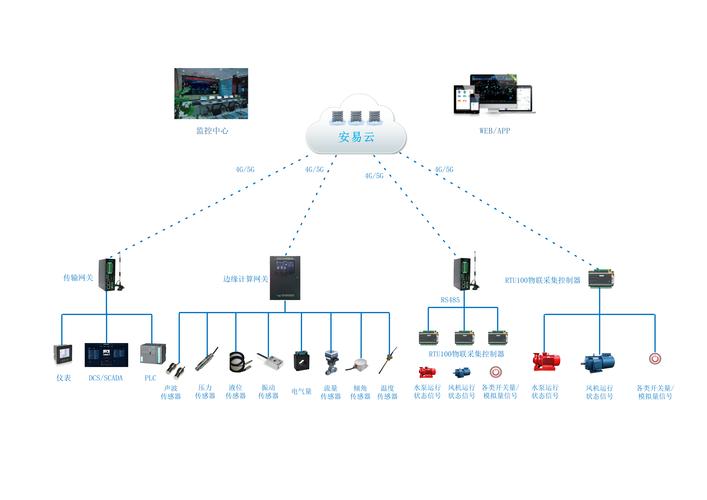
三、数据落湖之前,先想清楚“谁用、怎么用、用多久”
四、说点实际的选型建议和踩过的坑
如果你现在要建一个工厂物联底座,预算有限,团队三四个人。我的建议很直接:别自己造协议栈。 协议解析那层,能用商业网关就用商业网关。Kepware、Ignition、或是国内的几家做边缘计算的。它们把Modbus、Profibus、EtherNet/IP、OPC UA、MQTT的适配都做好了。你非要用开源方案自己拼,光一个OPC UA的证书管理就能让你加班一个月。而且现场调试的时候,商业网关的抓包工具和日志系统能省你半条命。 数据库选型,先看数据保留策略再选技术。 如果只存特征值,SQLite都够用。如果要存原始波形,老老实实上对象存储(MinIO之类的),把时间序列索引放在PostgreSQL里。别用时序数据库存波形,你会在磁盘IO上撞墙的。 边缘计算和云端的分工要明确。 我的经验是:边缘侧做毫秒级响应的逻辑,比如超限停机、联锁保护、简单的阈值判断。云端做分钟级以上的分析,比如趋势预测、健康度评分、报表生成。中间的传输层用MQTT,QoS设1,别设2。QoS 2的握手开销太大,在车间网络不稳定的情况下反而更慢。 最后说个真实教训。有一个厂,物联底座做得非常漂亮,数据采集完整、存储规范、还有个可视化的驾驶舱。 但设备科的老师傅根本不看。为什么?因为他关心的是“这台压缩机今天能不能撑到下班”。你给他看频谱瀑布图,他看不懂。后来我们把界面改了,就一个大按钮:绿色“继续运行”、黄色“安排检修”、红色“立即停机”。旁边一行字:“预计剩余寿命:7天”。老师傅一看就懂了。 物联底座的价值,不在技术堆栈有多先进。在于是不是把正确的数据,在正确的时间,用正确的方式,送到了正确的人手里。 螺栓松了,信号传到了,停机指令下了,砂轮没崩。这事儿就算成了。结论

