上周三下午,实验室那台老减速器试验台又跳停了。振动传感器底座松了半圈,学生没看出来。他盯着屏幕上的频谱图问我:老师,这个峰是不是故障?
我没答。反问他,这组数据是哪台设备、哪个工况、转速多少。
他翻了三页PPT,没找着。
——这就是我这门课每年都要重新讲一遍的地方。
先别急着建模,给数据做一次体检
机械专业的学生有个通病。拿到数据就想跑模型。Python、sklearn,几行代码,准确率98%,报告一交,完事。可你问他这98%是在什么之上算出来的,他就哑了。
我现在的做法很土。头一节课不发数据,发一张表。表上六列:测点编号、传感器型号、采样频率、量程、安装位置、标定日期。让他们去车间把这六列填满。

填不满。量程那一列,八成的人得去问老师傅。标定日期呢?工厂里压根没记录,传感器装上去就没动过,三年。
我说行,那就在报告里写“未知”。但你要知道它是未知的。这话听着像废话,其实是工业数据深度治理挖掘分析的头一道门槛——你得先知道自己不知道什么。
有个学生后来在周记里写:以前以为治理就是删掉空值和重复行,现在发现是搞清楚每一条记录背后站着什么人、什么机器、什么操作规程。这话我抄在了教案本上。
再往后我才敢往下推。分组做,一组七八个人,三周。中间穿插两次过堂,每组五分钟,讲清楚你手上这份数据的来源链路。讲不清的,回去重做。说实话,头两轮挺磨人的,教室里全是翻来翻去的声音。
挖掘的尺度,得由物理约束来定
齿轮箱那个例子我年年讲,但只讲五分钟。
学生拿到一段振动信号,先做FFT,看到一堆峰。他们说,峰就是要找的东西。我问:齿轮啮合频率在哪?算一下。齿数、转速,一乘就出来。
算完对上去,那个最高的峰,恰恰是啮合频率本身。它不是故障,它就是正常。
这时候他们才明白,纯数据驱动的方法为什么在工业场景里容易翻车——算法不知道什么叫“正常”,它只知道什么叫“和别的样本不一样”。而机械工程师的底气在于,我们知道这台机器应该长什么样。
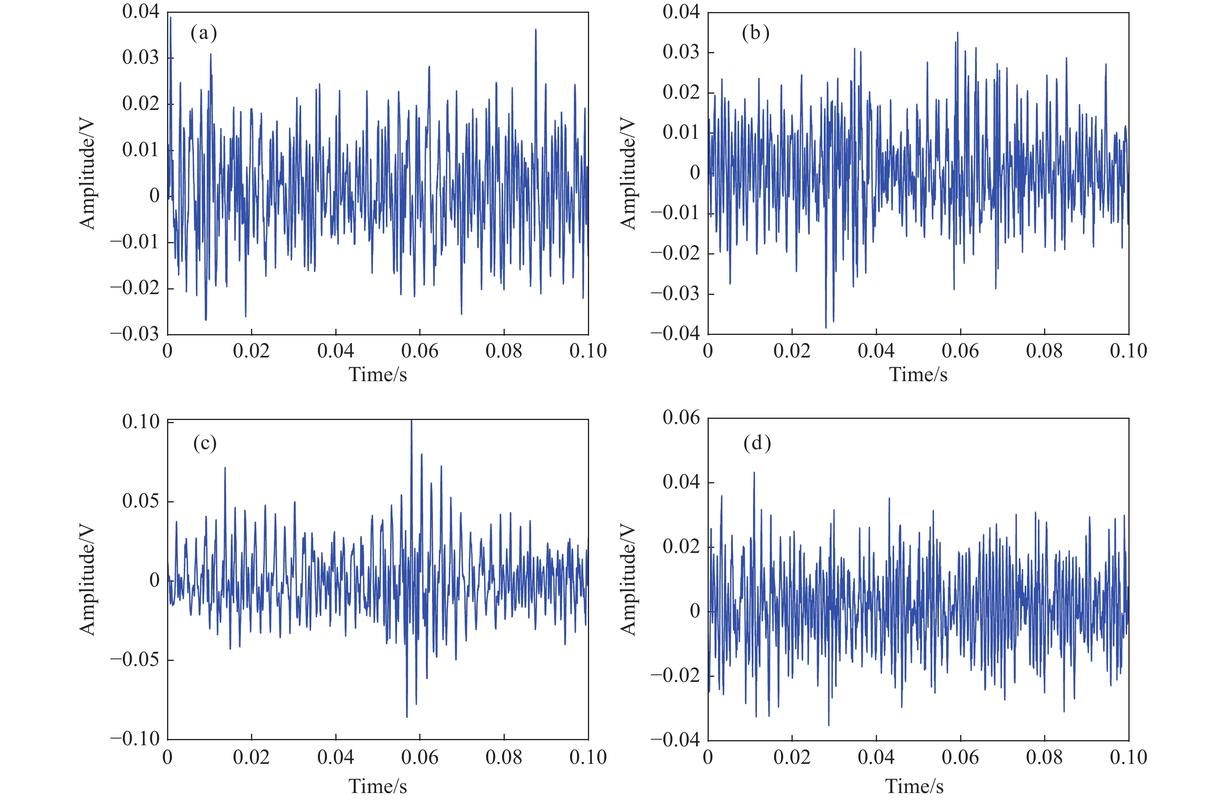
所以课上我反复强调:特征不是从数据里“长”出来的,是从物理里“推”出来的。数据干的活是验证,不是发明。
不过话说回来,也不能走另一个极端。有学生拿着教科书去套,说频谱里出现边频带就是调制、就是故障。结果那台设备刚换过联轴器,对中偏差本身就在合理范围内。数据得看,可也得连着工艺卡一起看。
工具链上我没太多执念。有人用MATLAB,有人用Python,还有一组拿Excel硬啃,我也不拦。卡人的从来不是工具,是工况标签怎么切。停机段、空载段、爬坡段,谁来标?标错了,后面全歪。有一年我干脆让两个组交叉标注同一份数据,再比对,差异率出来的时候教室里安静了几秒。
我自己翻过的车
头一年开这门课,我犯了个挺蠢的错。
我把治理压成一次两学时的讲座,剩下时间全留给挖掘和建模。理由是学生爱看结果,不爱做杂活。
期末交上来十二份报告。九份用的数据源是我提前清洗过的“干净版本”。他们连原始数据长什么样都没见过。其中一份写得挺漂亮,模型精度0.97,结论是“该设备运行良好”。可那台设备在采集期间停过三次。
停机段混在正常运行数据里,模型当然学不明白。它只会说“良好”。
转过年来我把课时倒过来。治理占三分之二,挖掘占三分之一。甚至有一周什么模型都不跑,就干一件事:把三个月的PLC日志按班次切开,对齐设备启停时刻。
枯燥吗?枯燥。但下课的时候有个学生跟我说:老师,我现在看时间戳,能看出哪台机器在加班。
我觉得这比0.97值钱。
几个还在试的做法
现在课上固定三样东西。
一是数据字典,每组自己写,写不清的字段标“待确认”,不许猜。
二是体检表:缺失率、异常段、量程超限、时间戳跳变,四项。填完才准进下一步。
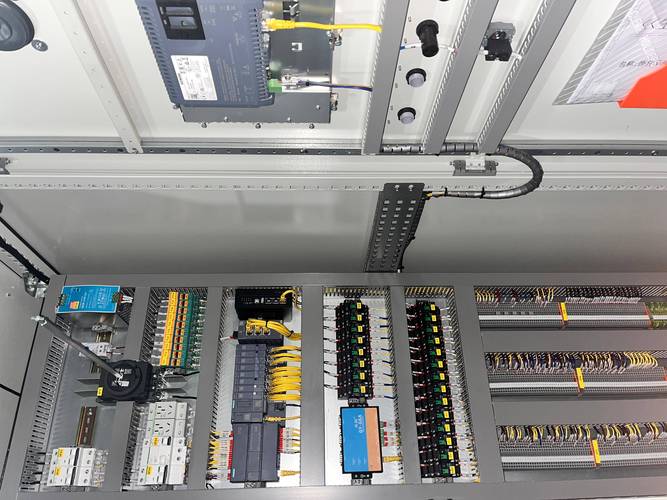
三是物理自洽检查。功率、转速、扭矩三个量,拿公式过一遍,对不上的回去查采集链路。这招筛出来的问题最多,有一次直接定位到某路接线端子氧化了。
效果?有好有坏。强的组能做到从原始日志到特征表全链路可追溯;弱的组还是卡在最后一步——治理做太细,没时间做分析。这个平衡我到现在也没拿准。下学期打算加条硬规矩:治理环节不超过总工时的四成,超了扣分。
是不是有点教条?可能吧。但学生需要一条线,先把习惯养起来,线以后再松。机械设计的人做这行,优势不在算法花哨,在于肯蹲下去看那台机器到底怎么转的。
写到这儿,想起上周那个学生后来又来找我。他把传感器底座拧紧了,重新采了一组数据,频谱干净不少。他站那儿看了半天,说了句:原来是松了。
我说,对,是松了。
数据不说话。是人替它说的。
