摘要:国内多数制造工厂完成自动化产线改造后,普遍存在运维靠人工、故障靠救火、停线损失说不清的问题,很多智能运维平台项目上线后成了摆设,本文结合我近五年经手的七个离散制造产线项目,聊聊智能产线运维管控管理平台落地过程中的核心设计要点、选型权衡和普遍踩过的坑,给有基础的中级工程师做参考。
别上来就堆传感器:先理清楚运维的核心需求
我见过太多项目,刚启动就恨不得给每颗螺丝都装个监测传感器。
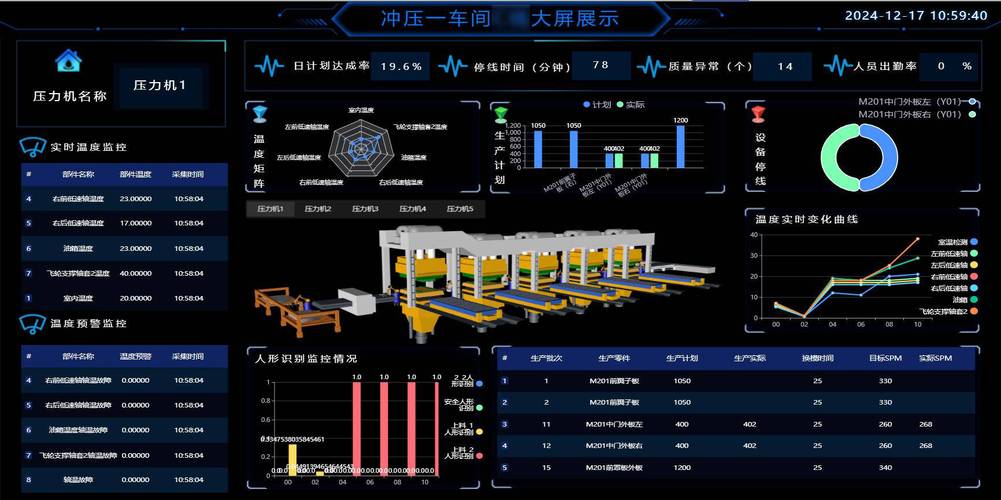
去年东莞那个汽车零部件冲压产线项目,甲方一开始拍板,要求12台压力机每个滑动轴承都装进口压电式振动传感器,算下来光传感器采购加布线就超了三分之一预算,后期算存储,光原始振动数据每个月就要17T,不出半年存储就要扩容。说实话,这完全没必要。
运维管控的核心需求从来不是全数据采集,而是三个:核心故障提前预警、产线能耗精准统计、停线原因快速溯源。对吧?不同等级的设备,完全可以用不同的监测方案。核心设备比如冲压机主轴、焊接机器人六轴减速机,要上高精度振动加温度监测;辅助设备比如输送线的从动滚轮、中转料架,只要采集驱动电机的电流数据就够了,电流异常足够反应负载故障,成本不到传感器方案的十分之一。
很多项目死在一开始就把摊子铺太满,预算烧完了,出不了核心效果,最后被甲方雪藏。
平台架构的选型权衡:别迷信公有云,适合产线才是对的
现在大大小小的厂商都在推全公有云方案,开口就是云原生大模型,好像不做公有云就不够智能。不过话说回来,国内大部分离散制造工厂,车间的外网都不稳定,有的出于数据保密要求,根本不让生产数据出厂区,你把所有运维数据放公有云?甲方生产部和信息部第一个不同意。
我三年前碰过一个3C组装线的项目,一开始选了某头部互联网厂商的公有云方案,上线前测稳定性,车间网络高峰期波动,十分钟断了三次,一千多条实时报警数据全丢了,差点整个方案推倒重来。后来改成边缘+私有云的架构,才解决问题。
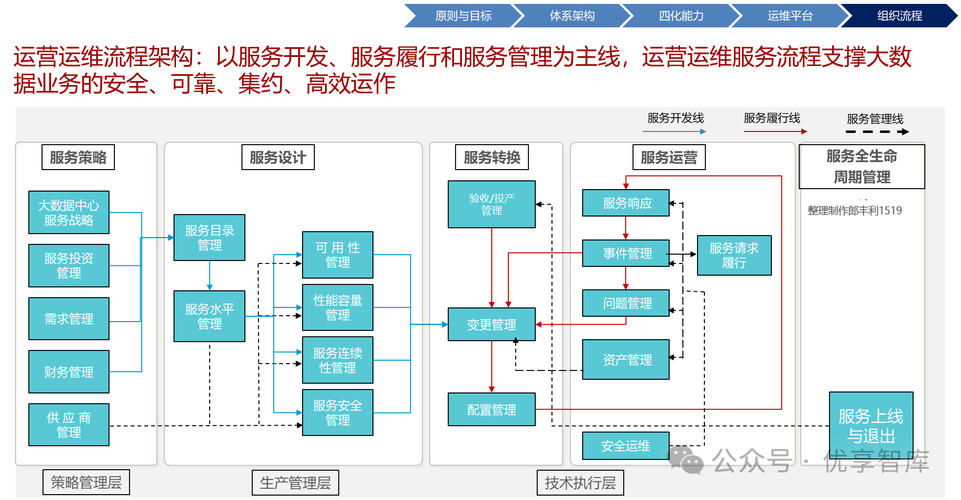
目前符合行业规范的通用架构是边缘数据层+厂区私有云层+可选云端同步层,完全符合GB/T 39116-2020《智能制造 能力成熟度模型》的三级能力要求。边缘层放在产线控制柜里,直接做数据预处理,异常数据触发本地报警,延迟能控制在100ms以内,不用等云端回传,只有汇总后的故障数据、统计报表才存在厂区私有云,需要总部远程监管的,再加密同步到云端,安全和速度都兼顾了。
这里再提个坑:数据交互一定要用标准OPC UA协议,别接受厂商的私有协议,不然以后产线换设备,新旧系统对接的工作量能把人熬吐,我吃过这个亏,不想你们再踩。
故障预警模型:别追求100%准确率,误报比漏报更可怕
很多做算法的工程师,上来就要做通用大模型,要把所有故障都识别出来,追求99%的准确率。可实际放到产线用,只要误报率超过5%,工人就不信你了。三天两头跑现场处理假报警,跑个几次,直接把报警关了,你平台做的再漂亮,不也是摆设?
还是那个3C组装线的项目,我们一开始训练的模型,整体准确率做到了92%,但是误报率有15%,工人每班要处理七八个误报警,怨声载道,线长找我吐槽了三次,说你们这个平台不如没有,耽误生产。后来我们改了触发规则:只有当两个及以上维度的参数同时超过阈值,才触发一级报警推送给运维,单一参数异常只做后台日志记录,定期优化模型。改完之后,误报率直接降到2%以下,虽然漏报率只上升了0.3%,但工人愿意用了。
漏报一两次,后续拿数据优化模型就行,误报多了,直接被用户弃用,整个项目就没了价值。而且对于产线上最多的旋转类设备,用行业通用的包络分析方法就足够解决80%的故障预警问题,计算公式为:$X(f)=\int_{-\infty}^{+\infty} x(t)e^{-j2\pi f t}dt$,成熟可靠,对数据标注量要求低,比很多花里胡哨的大模型好用多了。
最后还有个容易忽略的点:别只做报警,不做闭环。很多平台做出来,就只有数据报表和弹窗报警,报警发出去谁处理?什么时候处理完?处理结果对不对?全没跟踪。那叫什么管控?平台一定要加轻量化工单闭环模块,报警触发自动派单给对应责任人,处理完要上传记录线上验收,整个流程留痕,才能真正把运维管起来,而不是只给老板做个看数据的大屏。
做这个平台,本质就是帮工厂减少非计划停线,降本增效。别搞花里胡哨的概念,抓住核心需求,选对适配的架构,控制好误报,做完整闭环,就能落地出效果。就这么简单。
