摘要:工序追溯,说到底是在做一件事——把每一件在制品在每一道工序上“经历了什么”固化下来,并且保证以后还能调得出来。听起来朴素,真做起来,坑比想象的多。下面这些内容来自几条机加工产线的实际改造,有成功的,也有返工的。
一张糊掉的流转卡,暴露的是建模问题
先说个真实的。
某厂一批模数2.5的直齿圆柱齿轮,总装时发现齿面硬度只有52HRC,图纸要求58~62HRC。要查原因。查了三天,还是没定论。
卡在哪儿?渗碳淬火的炉次记录写在热处理车间的手工台账上,齿轮的流转卡跟着托盘走,而托盘在磨齿工序换过一次。新托盘上贴着旧批次的条码。于是那个经典问题冒出来了:这批齿轮到底出自A炉还是B炉?
难吗?技术上一点不难。但它暴露了一个根本性的东西——追溯的本质是建立实体之间的关系,而不是记录一堆字段。
用集合的语言写出来大概是这样:
产品实例 → 工序实例 → 资源实例(设备、人员、物料批次、工装)
这三层之间任何一条边断了,追溯就废了。上面那个例子里,断的是“托盘—批次”这条边。字段再全,也补不回来。

颗粒度:批次、单件、工序,成本差着量级

行业里聊追溯,绕不开一个问题:追到批次还是追到单件?
答案取决于你的失效模式和成本。ISO 9001:2015 第8.5.2条只要求“必要时”具备可追溯性,话说得很软;可到了汽车行业,IATF 16949:2016 第8.5.2.1条就硬了,明确要求对产品进行标识并保留可追溯记录,且保存期限为产品生命周期加一个日历年。航空航天那边更狠,GJB 9001C 对技术状态管理的要求,基本把单件级追溯写死了。
单件级追溯在机加工里意味着什么?每件都要打标,每道工序都要扫。节拍损失摆在那儿——一次扫码加确认,8到15秒。如果你的工序节拍是45秒,这一下就是二三十个百分点的产能。谁受得了。
所以实际做法多半是分层的:
普通结构件走批次级,炉号、料批、班组绑定到一张流转卡上;关键特性(CTQ)所在工序走单件级,比如曲轴的主轴颈尺寸、齿轮的齿形齿向、连杆的螺栓孔位置度;安全件、法规件走全流程单件级,刹车卡钳、转向节这类,没得商量。
判断哪种工序该升级到单件级,有个粗糙但好用的指标:
TCR = 可追溯工序数 / 关键特性工序总数
别追求100%,追求关键特性全覆盖。剩下的用批次封顶,够用了。
标识方案:别在油污面前谈理想
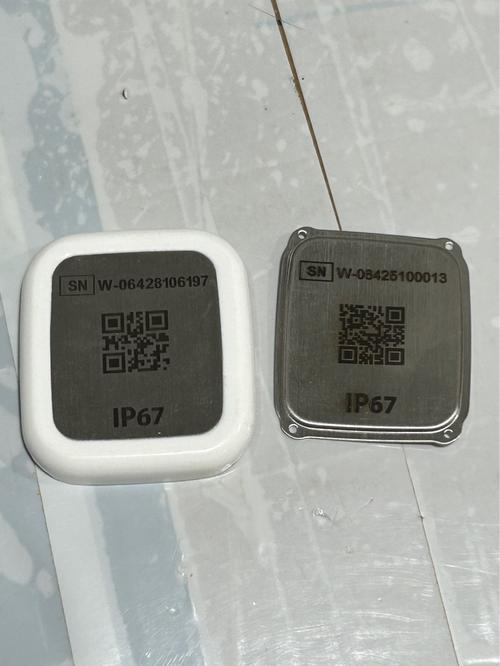
RFID、二维码、DMC、激光打标。选型的时候,实验室指标一文不值,现场的油污才是裁判。
我见过最典型的翻车:某产线在精车之后贴纸质二维码标签,理论读取率99.5%。上线第一周,识别率掉到七成。原因不复杂——切削液残留加铁屑,标签表面糊了一层,镜头对不上焦。后来改成托盘级RFID加成品激光打标DMC的组合,问题才算收敛。
机加工车间的经验值是:工序间流转用载体级标识(托盘、料箱),成本低、耐操;成品出厂用一物一码的直接零件标记(DPM)。ISO/IEC TR 29158 对DPM的等级有规定,一般要求达到B级以上,实际在铸铁件毛面上能稳定读到C级就已经不错了。
激光打标有几个参数要盯住:打标深度通常控制在0.02~0.05mm,太浅读不出,太深就是应力集中源。更麻烦的是热影响区。轴承钢、渗碳钢这类材料,在高应力区打标等于埋裂纹源。所以打标位置一定得避开齿根、轴肩圆角、螺纹根部这些地方。别为了追溯方便,牺牲零件的疲劳寿命。
时间戳与数据断点,这才是真正的杀手
现场数据采集做完之后你会发现,最麻烦的根本不是读码,是时间。
PLC的时钟每个月漂几分钟,一条产线上十几台设备各说各话。MES拿到的完工时间戳,和设备的实际加工结束时间差着十几秒甚至几分钟。单看没什么,等到你要做“某批次零件是否经过热处理炉升温异常的那17分钟”这种查询时,误差就直接让结论失真了。
怎么办?NTP或PTP全厂统一授时,这是底线,没有商量余地。设备侧统一走OPC UA或MTConnect上报,采样周期和MES记录周期对齐。听着像IT的事,可工艺工程师必须参与定这份时间基准。
另一个隐蔽得多的问题:补录。
夜班操作工嫌麻烦,早上交班前一次性把整晚的扫码记录补上。数据看板上密密麻麻,全是漂亮的数据。时间戳全是假的。这类数据在追溯里叫污染数据,比没有还危险——它会让你在排查时得到一个自信的错误结论。
最有效的对策是做互锁。机床只有在读到工件ID之后才允许调用加工程序;检验工位只有在扫码后才开放数据录入界面。狠,但管用。人总是倾向于走阻力最小的路径,与其靠制度约束,不如把捷径堵死。
最小可用实现:字段不求多,关系不能断

如果你现在要从零搭一套,别被供应商的方案书吓住。先定最小字段集,跑通了再说。
核心字段就这些:工件或批次UID、工序号、设备ID、操作者ID、开工与完工时间戳、关键工艺参数快照、检验结论、上道工序的UID。
那个上道工序UID,最容易漏,也最关键。它把单层的工序记录串成了链,也就是一张有向图。查询“某件产品用了哪批毛坯”,本质上是在这张图上做一次递归回溯。关系型数据库用递归CTE能撑住,几十万条记录量级没太大问题;再往上,或者关系维度特别复杂(比如一个装配件由多个子件构成,子件又有自己的完整链条),就得上图数据库了。
工艺参数快照这块,别想着全采。主轴转速、进给、切削液压力、扭矩这些,只在你识别出的关键工序上采,其余留个“合格”结论就行。数据不是越多越好,是越准越好。采集点铺得越广,维护成本越高,最后没人维护,整套系统烂在那儿——这种事我见过不止一次。
一点不太系统的收尾
追溯做得好的工厂,往往不是软件买得最贵的,而是现场纪律最扎实的。系统的天花板,就是车间里那台扫码枪被摔了几次之后的存活状态。
先想清楚失效模式,再定颗粒度;先定标识载体,再选读写设备;先把时间基准统一,再谈数据平台。顺序反了,钱就白花了。
