很多工厂上了数字化、智能制造之后,都遇到一个怪事:算总算力明明够,用的时候总是抢不够,要么闲的闲死,要么忙的忙死。本文整理了我在多个离散制造工厂做数字化改造攒下的实际经验,说说怎么把算力用明白,少花钱多办事。
为什么你厂的算力总不够用?
三年前在长三角某汽车冲压件厂改数字孪生,甲方IT负责人拍着胸脯说,刚采购了8台边缘服务器,总算力320核1TB显存,绝对够跑所有新应用。结果上线第一个星期就炸锅。
三坐标检测完一个新车型的模具,点云建模要跑两小时,结果车间16台AGV的调度系统+四条冲压线的实时监控占了近80%的算力,建模程序卡得动不了。等排上队的时候,已经过了交付时间。全组跟着扣钱。说多了都是泪。
后来我们拉了一个月的算力日志统计,吓一跳。整厂平均算力利用率不到32%。一半服务器白天满负荷,夜里连个任务都没有,另一半服务器闲了一天,只跑夜里的批量数据备份。
说实话,绝大多数工厂的算力都是碎片化的。每个工位、每个车间上数字化项目的时候各自买服务器,各自管各自的,从来没全局调度过。新任务来了就加钱买新服务器,买完还是不够用,陷入死循环。
工厂算力调度的核心落地逻辑
别听云厂商瞎吹什么大一统全局调度,工厂场景和互联网不一样,第一要保生产,第二才是提利用率。我们现在做项目都是按三级分层调度,踩过无数坑之后磨出来的框架。
把工厂算力分成三层:边缘工位算力、厂区私有云算力、公有云弹性算力,不同层级放不同类型的任务,按优先级分配。
根据GB/T 39116-2020 智能制造能力成熟度模型的要求,实时生产控制类任务,端到端最大延迟不能超过10ms。这类任务必须锁死边缘工位的预留算力,优先级最高,任何情况都不能被抢占。一般我们会给边缘节点预留15%-20%的固定算力,专门给这类任务用,哪怕空着也不能给其他任务用。
非实时的任务呢?比如批量质检的AI推理、每周的工艺仿真、模具点云建模这些,对延迟要求不高,只要几个小时内出结果就行,就统一收到厂区私有云排队,错峰调度。我们常用的调度评分公式很简单:
$$S = \alpha(1-U_i) + \beta(1-L_i/L_{max}) + \gamma P_j$$
其中$U_i$是第i个算力节点当前的利用率,$L_i$是节点i当前的平均任务延迟,$P_j$是第j个任务的优先级,α、β、γ是根据工厂实际情况调的权重,一般我们会设成0.3、0.2、0.5,优先级占比最高,不会出错。
遇到超大任务,比如全车间的数字孪生仿真,私有算力不够用的时候,再弹性调度到公有云,按使用付费,比自己买一大堆服务器闲放着划算多了。
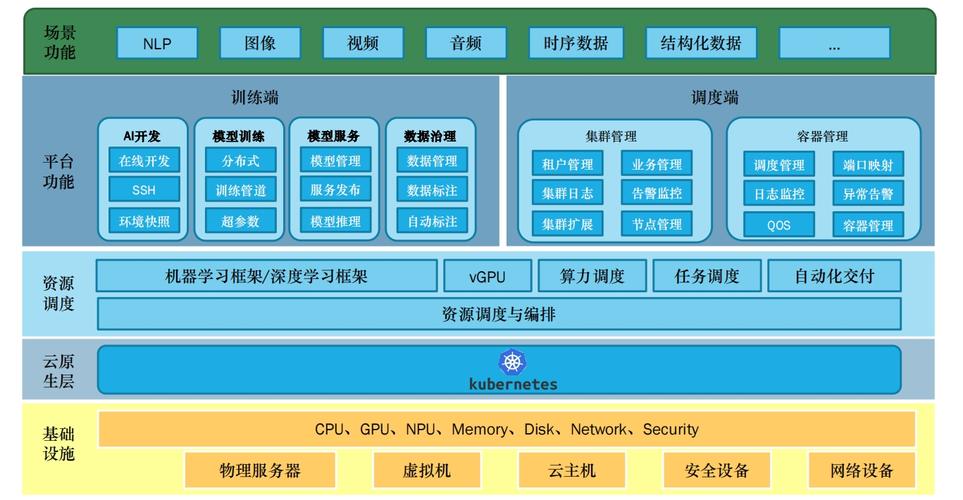
这么调完之后,我们测过,大部分离散工厂的算力利用率能从30%出头拉到70%以上。原来要花几百万新增服务器的项目,改完调度之后几十万就搞定了。香不香?
三个踩过的深坑,劝你别跳
第一个坑,过度追求云边一体化,把实时生产任务往公有云扔。去年听一个同行说,某汽配厂把冲压线的安全监控放到公有云调度,结果园区5G断了12分钟,整条线停摆,压坏了三块模具,损失近百万。所以记住,涉及生产安全的实时任务,永远放在本地边缘,绝对不能往外走。
第二个坑,不预留冗余算力,把所有算力都排满任务。我自己踩过的坑。刚做第一个调度项目的时候,为了追求高利用率,把所有空闲算力都排了批量推理任务,结果某一天工艺出了问题,要紧急跑一个仿真改参数,愣是找不到一块空闲算力,等了两个小时排上队,整批次零件已经报废,十几万打水漂。现在做任何调度方案,我都会给厂区私有云留10%的应急冗余,空着也没关系,就怕万一。
第三个坑,不做算力节点画像,乱调度。之前有个AI视觉批量质检的任务,需要4G显存才能跑,结果调度系统只看CPU利用率,给分到了一台CPU利用率只有20%但显存只有2G的老服务器上,跑了半小时直接崩了,重新排队又等了两个小时。所以,调度之前一定要给每个算力节点打标签:显存多大、CPU主频多少、支持不支持AI加速,标签对上了再调度,别瞎抢。
不过话说回来,工厂哪有完美的算力调度方案?能解决问题,能省钱,就是好方案。
写在最后
工厂算力调度,本质不是技术炫技,是给生产做后勤。别跟风上那些花里胡哨的概念,先把自己工厂的任务分好类,把坑都避开,就能把利用率提上去,省下真金白银。
